内存芯片逆势上扬,脱离科技股抛售潮——华尔街是否正在重新评估该板块?


📊 研究简报:【被冤枉了!】
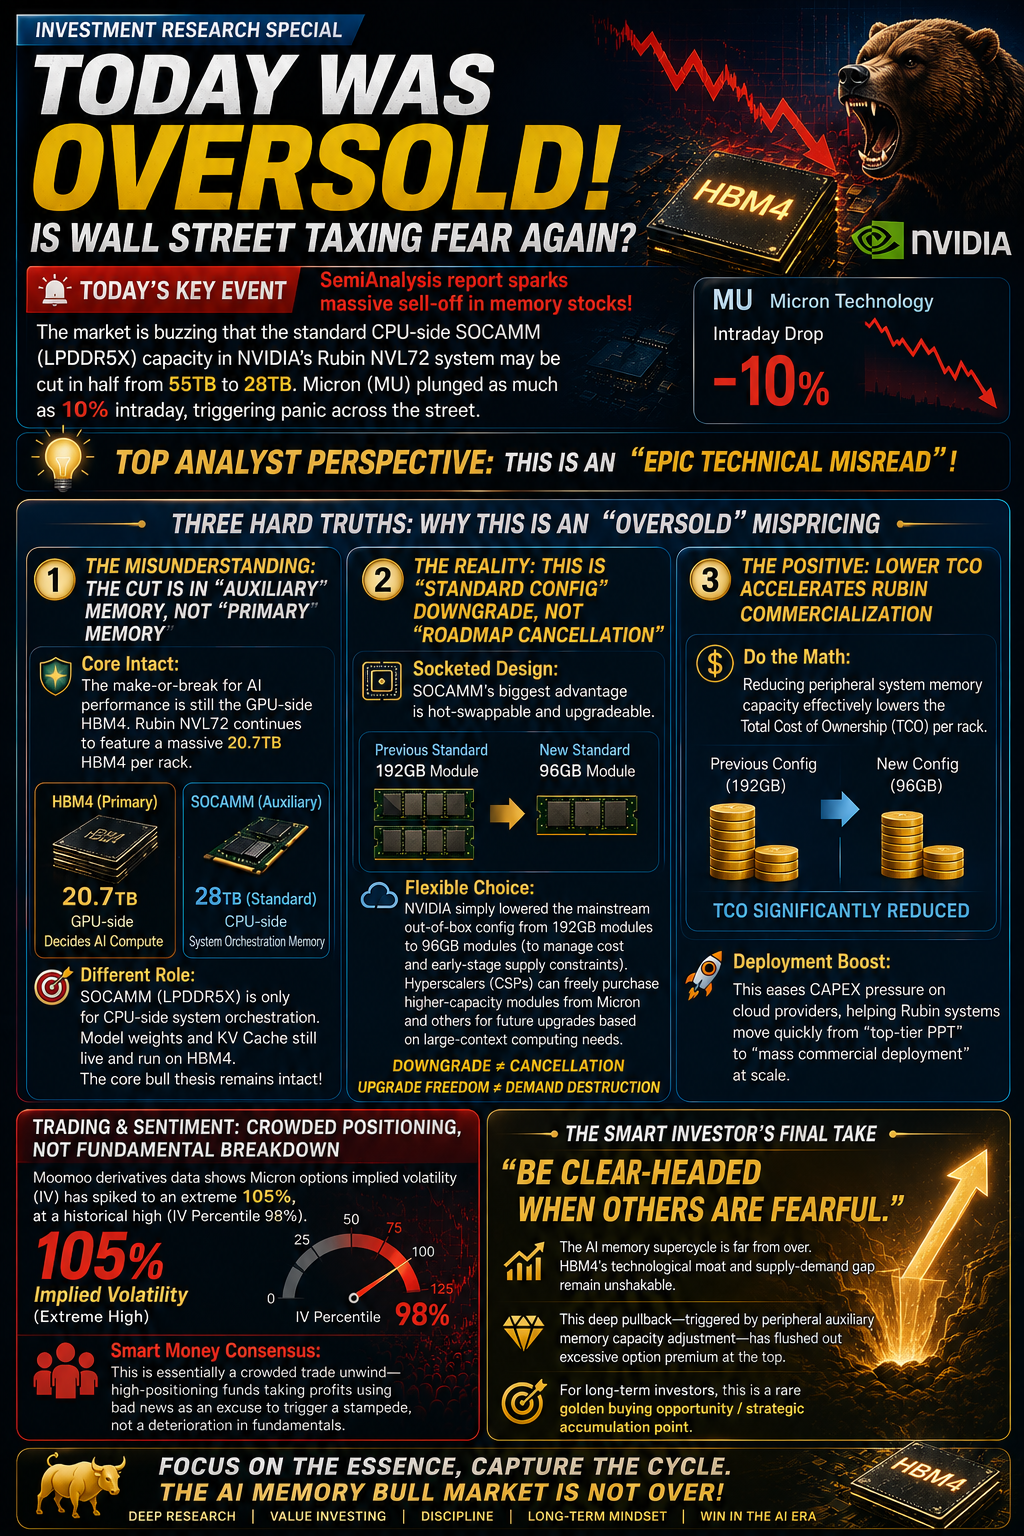
一份SemiAnalysis的报告引发了存储芯片股的算法性崩盘。
有报道称, 英伟达可能会将其主流Rubin NVL72系统中CPU端的SOCAMM(LPDDR5X)DRAM容量从每机架约55TB削减至约28TB对此,美光科技(MU)盘中股价一度暴跌10%,拖累整个内存与存储板块下行。
💡 这是一个典型的“技术性误读”,也是市场过度反应的表现。
🔍 真相:内存股被错怪的三大原因
1️⃣ 找错了“元凶”:削减的是“系统内存”,而非AI核心内存
HBM4未受影响: AI性能的生命线在于GPU端的HBM4内存。Rubin NVL72架构仍为每机架锁定高达20.7TB的HBM4内存(72颗GPU共计288GB)。
角色不同: SOCAMM仅作为CPU端的系统调度内存。模型权重、KV缓存和训练吞吐量仍然完全依赖HBM4。AI核心投资逻辑依然坚如磐石。
2️⃣ 模块化至关重要:这只是“默认配置的小幅下调”,而非结构性削减
插槽式架构: SOCAMM 是一种非焊接的模块化格式。
配置灵活性:将主流配置从192GB模块转向96GB模块,是为了应对短期内的供应限制和良率问题。由于采用插槽式设计,超大规模云服务商(CSP)仍可完全自主选择从美光(Micron)等供应商处采购更高容量的192GB模块,在购买后根据长上下文工作负载需求升级其服务器机架。
3️⃣ 总拥有成本(TCO)优势:更低的成本 = 更快的大规模部署
经济现实:高容量192GB LPDDR5X模块价格昂贵。将默认SOCAMM容量减半,可大幅优化初始机架成本。
加速扩展: 降低企业客户的准入门槛(TCO),使Rubin平台更易于大规模部署,从而提前实现商业化落地的时间表。
结构性AI内存周期尚未见顶。高带宽内存(HBM4)的巨大供需缺口仍未解决。由外部系统内存规格调整引发的深度回调是健康的;它们会压低虚高的期权溢价,为长期科技投资者打开极具吸引力的战略性买入机会。

免责声明:社区由Moomoo Technologies Inc.提供,仅用于教育目的。更多信息

评论(3)
发表评论
60
7